Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

有趣分享
有趣分享
研究竞争对手网站,不必一篇篇打开文章。通过 robots.txt 找到 Sitemap,提取所有 URL,再使用 Google Sheets 统计不同目录下的页面数量,就能快速了解网站的内容布局。本文详细介绍 Sitemap 查找、URL 提取、正则公式、数据透视表和 SEO 结构分析方法。
研究竞争对手的网站,很多人习惯先打开首页,再一个个点击分类、文章和产品页面,试图了解对方主要做什么内容。
这种方法不仅耗费时间,而且很容易遗漏网站中大量的页面。
其实,有一个更直接的方法:查看网站的 Sitemap(网站地图),把所有 URL 导出来,再通过表格统计不同目录下的页面数量。
例如,一个网站可能有几千个 /compare/ 页面,几百个 /templates/ 页面,还有几十个普通博客文章。
通过这些 URL 的分布,就能初步判断这个网站重点布局了哪些内容类型,以及它可能采用了什么 SEO 内容策略。
整个过程不需要购买昂贵的 SEO 工具,使用浏览器和 Google Sheets 就可以完成。
Sitemap 通常称为网站地图,是网站提供给搜索引擎的 URL 列表。
它的主要作用是帮助 Google 等搜索引擎发现网站中的重要页面,了解网站的页面结构和更新情况。
一个网站的 Sitemap 可能包含:
例如,某个网站的 Sitemap 里可能有这样的 URL:
https://example.com/blog/seo-guide/
https://example.com/blog/keyword-research/
https://example.com/compare/tool-a-vs-tool-b/
https://example.com/compare/tool-c-vs-tool-d/
https://example.com/templates/business-plan/
https://example.com/templates/marketing-plan/
从这些 URL 就能看出,网站不仅有普通博客内容,还专门建立了工具对比和模板资源页面。
如果进一步统计每个目录下的 URL 数量,就可以更直观地了解网站的内容分布。
需要注意,Sitemap 是网站主动提交或公开的 URL 列表,不一定包含网站上的所有页面,也不代表里面的每个页面都已经被 Google 收录。
分析网站之前,首先要找到它的 Sitemap 地址。
最简单的方法是查看网站的 robots.txt 文件。
在浏览器地址栏输入:
https://目标域名.com/robots.txt例如:
https://example.com/robots.txt打开后,通常可以看到类似这样的内容:
User-agent: *

Disallow: /admin/

Sitemap: https://example.com/sitemap.xml
重点关注最后的 Sitemap 地址。
网站管理员通常会在 robots.txt 中声明网站地图的位置,这样搜索引擎就能更容易发现它。
如果出现:
Sitemap: https://example.com/sitemap_index.xml说明网站可能使用了 Sitemap Index,也就是网站地图索引文件。
直接打开这个地址,就可以继续查看它包含的子 Sitemap。
如果 robots.txt 中没有写 Sitemap,也可以尝试一些常见地址:
https://example.com/sitemap.xml
https://example.com/sitemap_index.xml
https://example.com/wp-sitemap.xml
https://example.com/sitemap/
如果网站使用 WordPress,可能会使用 WordPress 自带的网站地图:
https://example.com/wp-sitemap.xml如果安装了 Yoast SEO、Rank Math 等 SEO 插件,也可能使用插件生成的 Sitemap Index。
不过,这些只是常见地址,不是每个网站都会使用。
如果以上地址都打不开,也不代表网站没有 Sitemap。有些网站会使用自定义路径,或者根本没有公开网站地图。
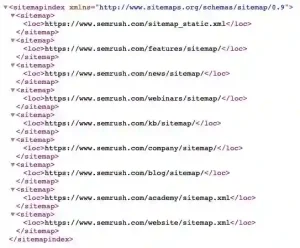
如果打开网站地图后,看到的不是一大串 URL,而是类似下面的 XML 内容:
<sitemapindex>
    <sitemap>
        <loc>https://example.com/post-sitemap.xml</loc>
    </sitemap>

    <sitemap>
        <loc>https://example.com/page-sitemap.xml</loc>
    </sitemap>

    <sitemap>
        <loc>https://example.com/product-sitemap.xml</loc>
    </sitemap>
</sitemapindex>
这就是 Sitemap Index。
它相当于一个总目录,里面包含多个子 Sitemap。
例如:
| 子 Sitemap | 可能包含的内容 |
|---|---|
| post-sitemap.xml | 博客文章 |
| page-sitemap.xml | 独立页面 |
| product-sitemap.xml | 产品详情 |
| category-sitemap.xml | 分类页面 |
实际文件名称取决于网站使用的系统和 SEO 插件。
分析时,不要只看 Sitemap Index 本身,而是要把里面的子 Sitemap 全部打开。
因为真正的页面 URL 通常都在子 Sitemap 里面。
有些网站会提供 .xml.gz 格式的压缩 Sitemap。
例如:
https://example.com/sitemap.xml.gz这也是正常的 Sitemap 格式,可以使用浏览器、解压工具或支持 XML Sitemap 的爬虫工具处理。
如果网站的 Sitemap 数量非常多,建议使用工具批量提取 URL,而不是手动复制。
找到 Sitemap 后,下一步就是整理 URL。
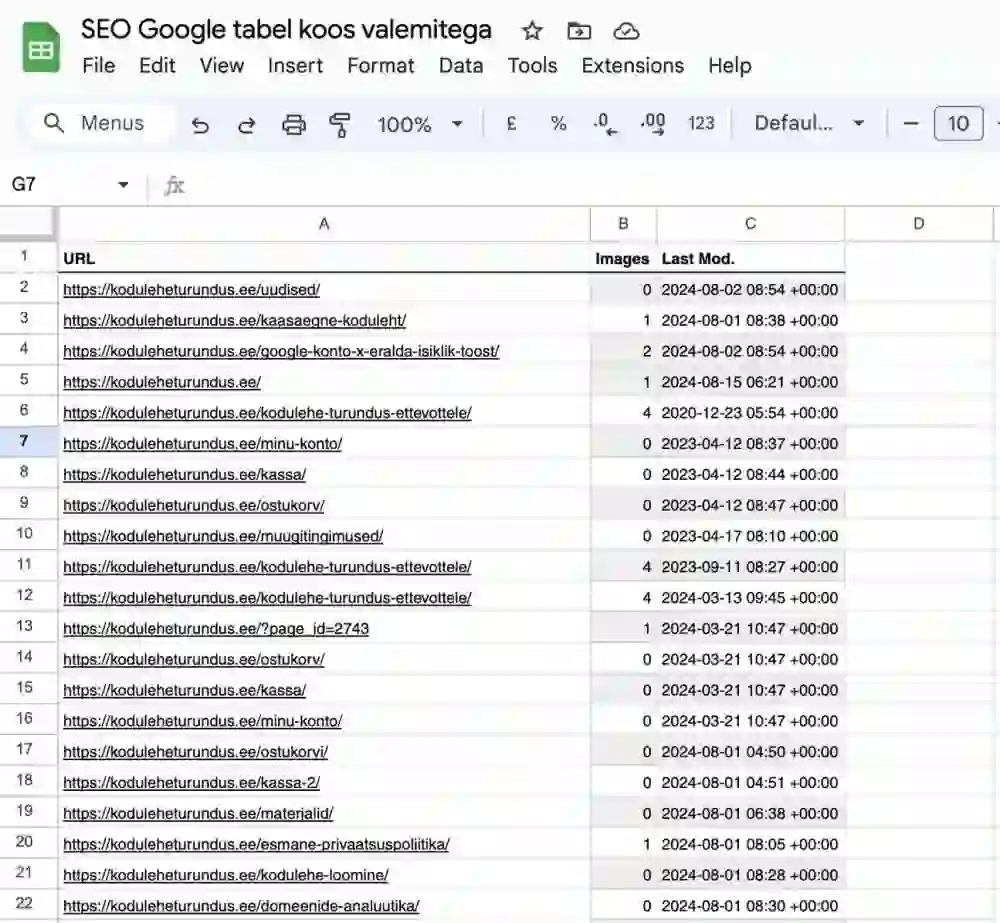
假设你已经从 Sitemap 中提取出一批链接,可以把它们放到 Google Sheets 中。
例如,在 A 列放置 URL:
接下来,我们需要从 URL 中提取第一级目录。
在 B2 单元格输入:
=IFERROR(REGEXEXTRACT(A2,"https?://[^/]+/([^/?#]+)"),"(根目录)")然后向下填充公式。
这个公式的作用是:
https?://:匹配 HTTP 或 HTTPS。[^/]+:跳过域名部分。/([^/?#]+):提取域名后第一个路径片段。IFERROR:如果 URL 没有目录,就显示“根目录”。处理后的结果大致如下:
这样就能快速把不同 URL 按照目录分类。
例如,你想分析:
https://example.com/blog/seo/keyword-research/不仅想知道它属于 blog,还想知道第二级目录 seo。
可以使用:
=IFERROR(REGEXEXTRACT(A2,"https?://[^/]+/[^/]+/([^/?#]+)"),"")这样就可以进一步了解网站的目录层级。
如果网站 URL 使用多语言路径,例如:
https://example.com/en/blog/article/
https://example.com/zh/blog/article/
还可以分别统计语言目录和内容目录,避免把不同语言版本混在一起。
URL 已经整理完成,接下来就是统计。
Google Sheets 自带数据透视表,不需要编写复杂程序。
操作步骤:
完成后,就能看到类似这样的统计结果:
| 网站目录 | URL 数量 |
|---|---|
| compare | 2,500 |
| blog | 680 |
| templates | 420 |
| tools | 160 |
| about | 5 |
上面的数据只是演示,并不代表某个真实网站的统计结果。
但通过这样的表格,就能很快发现网站的页面主要集中在哪些目录。
例如:
/compare/ 有 2500 个页面。/blog/ 有 680 篇文章。/templates/ 有 420 个模板页面。/tools/ 有 160 个工具页面。这说明该网站可能不仅依靠博客文章获取流量,还投入了大量资源建设对比页面和模板页面。
相比一篇篇阅读文章,这种方式能更快了解网站的内容布局。
统计完成后,不要只停留在数字上。
真正有价值的是分析这些页面为什么会大量出现。
例如,一个网站有几千个 /compare/ 页面,就值得进一步研究它的页面类型。
例如:
/compare/chatgpt-vs-claude/
/compare/notion-vs-evernote/
/compare/canva-vs-adobe-express/
这类页面通常围绕两个产品或工具进行比较。
可能包含:
这种内容主要覆盖“工具 A 和工具 B 哪个好”“A 与 B 有什么区别”等搜索需求。
如果一个网站大量建设这类页面,说明它可能把产品对比作为重要的内容方向。
例如:
/templates/business-plan/
/templates/marketing-plan/
/templates/project-management/
这类页面通常提供可下载模板、在线模板或者使用说明。
它们可能覆盖:
模板类页面能够满足用户寻找具体资源的需求,因此也是值得研究的内容类型。
例如:
/tools/image-compressor/
/tools/word-counter/
/tools/pdf-converter/
这类页面可能对应网站提供的在线工具。
如果一个网站有大量工具页面,可以进一步研究它是否通过免费工具吸引搜索流量,再通过广告、订阅或其他产品实现商业化。
例如:
/blog/seo-guide/
/blog/wordpress-tutorial/
/blog/website-speed/
博客文章通常用于提供教程、经验、问题解决方法和行业知识。
如果网站的 /blog/ 目录页面数量最多,可能说明它主要采用传统内容营销模式。
但需要注意,页面数量只是一个线索,不能直接判断哪个目录贡献了最多流量或收入。
找到页面数量最多的目录后,下一步就是打开里面的页面。
不要只看一篇,建议随机抽取 5 到 10 个 URL。
重点观察以下几个方面:
| 分析项目 | 需要观察什么 |
|---|---|
| 页面标题 | 标题使用什么关键词和句式 |
| H1 标题 | 是否与页面标题一致 |
| 页面结构 | H2、H3 如何安排 |
| 内容长度 | 页面内容是简短还是详细 |
| 表格 | 是否使用功能、价格或参数对比 |
| 图片 | 是否有产品截图、示意图 |
| 内链 | 是否链接到其他相关页面 |
| 外链 | 是否引用官方资料或产品网站 |
| 更新信息 | 是否展示更新时间 |
例如,你发现某个网站有 2000 个产品对比页面。
随机打开其中 10 个,可能会发现它们采用相似的结构:
这说明网站可能建立了一套标准化的内容模板。
再结合它的 URL 结构和页面内容,就能进一步了解它的内容生产方式。
不过,不建议直接复制竞争对手的文章。更好的方法是研究其页面结构,再结合自己的实际资料、测试结果和原创观点,制作更有帮助的内容。
如果想更深入地分析一个网站,可以继续观察 URL 的命名方式。
例如:
/compare/product-a-vs-product-b/
/compare/product-a-vs-product-c/
/compare/product-b-vs-product-d/
这些 URL 可能使用了固定的页面生成规则。
再比如:
/tools/pdf-to-word/
/tools/pdf-to-jpg/
/tools/word-to-pdf/
这类 URL 可能说明网站围绕文件格式转换建立了多个工具页面。
还可以观察 URL 中是否存在:
这些信息能够帮助你判断网站是否采用了规模化内容布局。
但需要注意,页面数量多并不意味着 SEO 效果好。
大量相似页面如果缺少独立价值,可能造成重复内容、低质量页面和搜索引擎抓取资源浪费等问题。
因此,研究竞争对手时,不要只关注它生成了多少页面,还要观察这些页面是否真正解决了用户的问题。
通过 Sitemap 分析网站结构很方便,但它并不能代表网站的全部 SEO 情况。
以下几点需要注意。
有些网站只提交重要页面,部分分类、标签、搜索结果或动态页面可能没有出现在 Sitemap 中。
所以,统计出来的数量只是 Sitemap 中公开的 URL 数量。
一个 URL 出现在 Sitemap 中,不代表 Google 已经抓取或收录它。
同样,一个网站没有在 Sitemap 中列出某个 URL,也不代表这个页面一定没有被搜索引擎发现。
某个目录下有 5000 个页面,不代表它一定比只有 100 个页面的目录获得更多流量。
想进一步判断流量情况,还需要结合公开搜索结果、关键词排名信息和其他 SEO 分析数据。
如果是自己的网站,则可以使用 Google Search Console 和 Google Analytics 等工具查看实际数据。
一个网站可能拥有大量程序化生成的页面,但这些页面不一定都有独立价值。
真正值得研究的是:
对于准备经营自己网站的人来说,这些比单纯追求 URL 数量重要得多。
如果你正在运营 WordPress 博客、独立站或者工具网站,研究竞争对手的内容结构是 SEO 工作中很有价值的一部分。
以后遇到一个值得研究的网站,不必急着从首页开始一篇篇阅读。
可以先按照下面的流程操作:
robots.txt。通过这套方法,你可以快速了解一个网站主要布局了哪些内容类型,以及它可能采用了怎样的 SEO 内容策略。
研究竞争对手,不是为了复制它的页面,而是为了发现自己还没有覆盖的搜索需求。
对于网站运营者来说,Sitemap 不只是提交给搜索引擎的网站地图,也是一份值得研究的公开内容结构清单。